 AIGC.promo
DeepSeek 把 Agent 的"隐形成本"打下来了
账单的大头不是想对了,而是绕路了。V4.1-Flash-1017 同时压低分数、耗时、token 三个变量,自反馈 RL 拆掉废话的根因。
10 月 17 日,DeepSeek 悄悄上线 V4.1-Flash-1017。没有发布会,模型列表先被网友蹲到、几小时后又火速下架,接口的系统指纹也换了。热闹之外,这次更新真正值得展开的是两件事:一条被掰弯的成本曲线,和一块补齐的 Agent 基础设施拼图。
一、Agent 的钱,到底花在哪了
用 Agent 干过活的人都知道,账单的大头从来不是"想对了",而是"绕路了":
- 为了对冲不确定性,模型倾向于多想几步、多解释几句;
- 输出 token 单价高于输入,废话直接等于钱;
- 链路越长,失败重跑的概率越高,隐形成本再翻一层。
所以过去行业的默认叙事是:模型越强 → 思考越长 → 输出越多 → 账单越厚。涨分和涨成本绑死在一起,大家只能在帕累托前沿上做取舍。
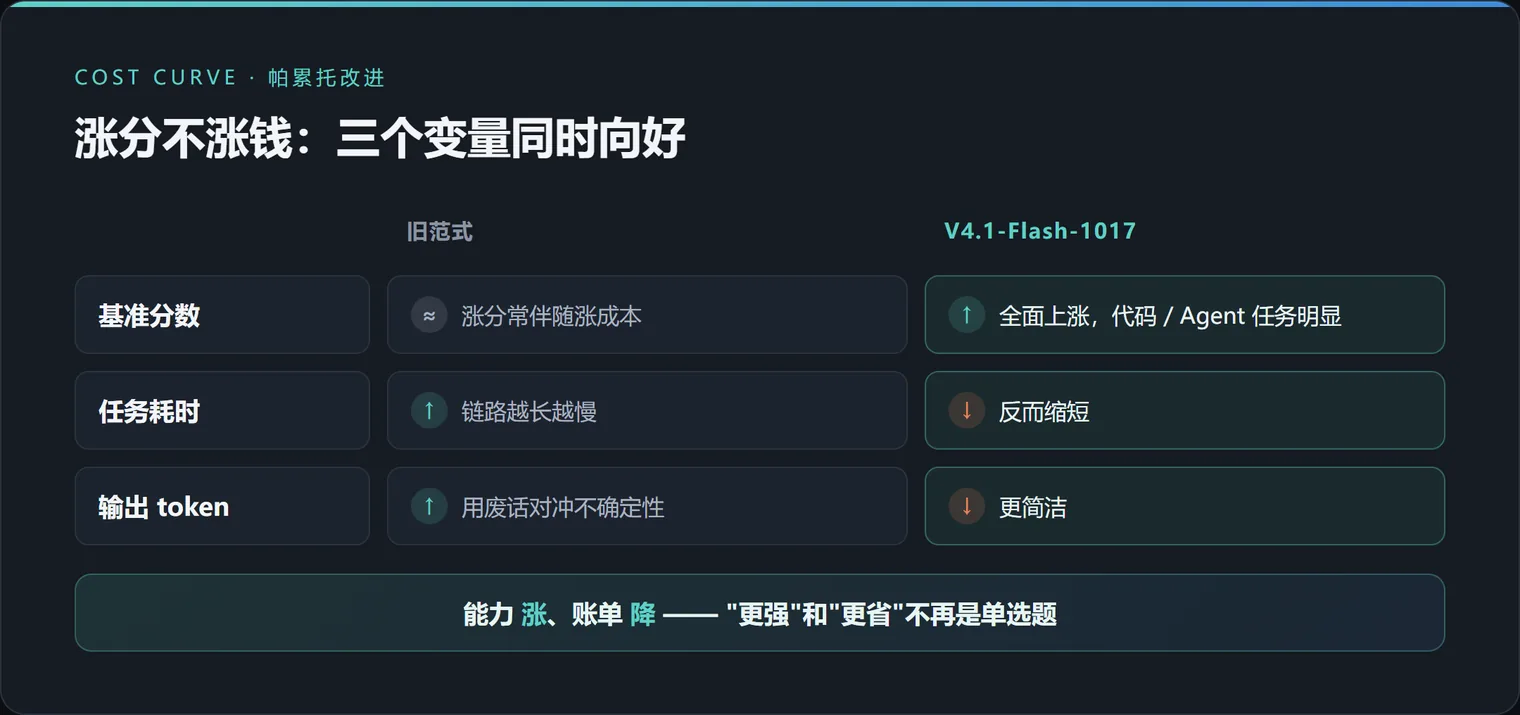
V4.1-Flash-1017 的官方说法是"性能—费用的帕累托改进":基准测试几乎全面上涨(代码、Agent 任务尤其明显),但任务运行时间和输出长度同时被压了下来。三个变量同时往好的方向走,这才是这次更新真正的信息量。
| 变量 | 旧范式 | V4.1-Flash-1017 |
|---|---|---|
| 基准分数 | 涨分常伴随涨成本 | 上涨(代码 / Agent 任务明显) |
| 任务耗时 | 链路越长越慢 | 反而缩短 |
| 输出 token | 用废话对冲不确定性 | 更简洁 |
| 结果 | 账单随能力一起涨 | 能力涨、账单降 |
二、靠什么做到:模型学会了"自己验收"
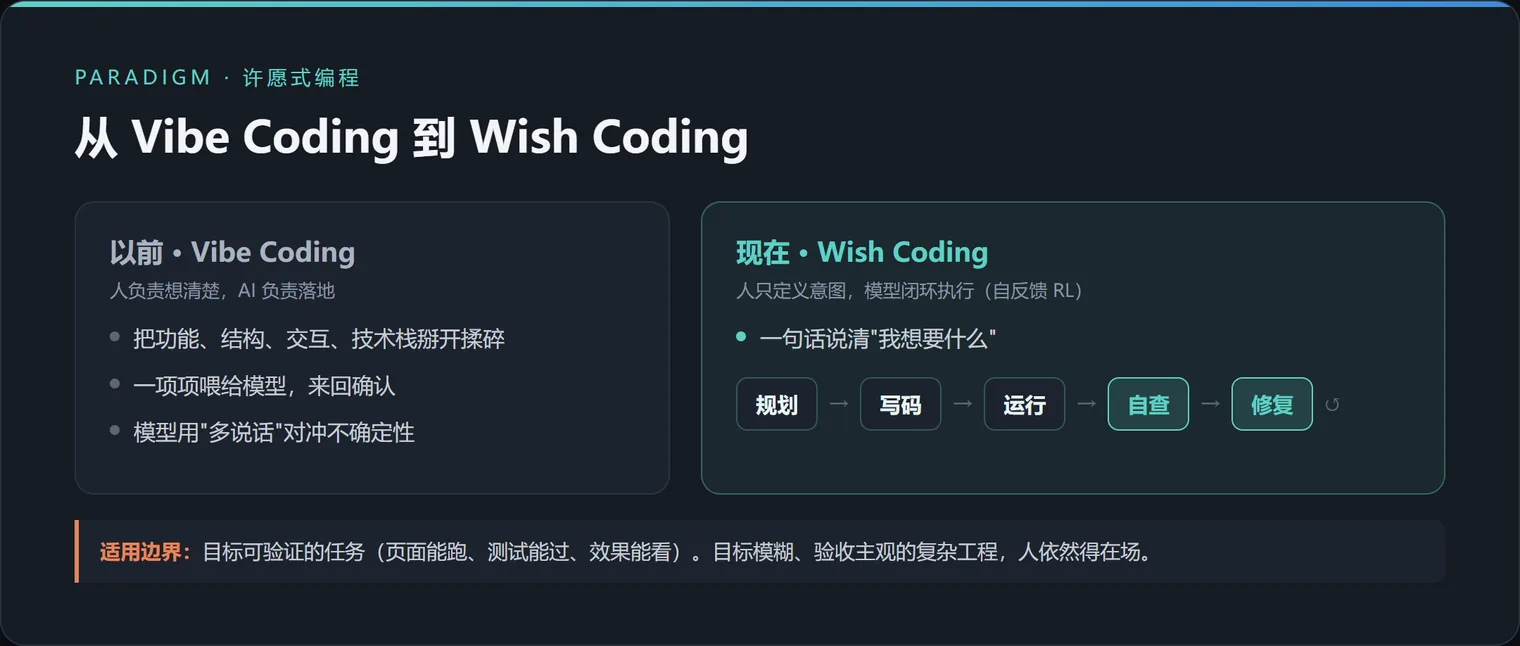
底层是一套基于自反馈的强化学习:模型生成第一版后不急着交差,先自己检查、发现问题、回头修,验收通过才算完成。
这件事的经济学意义比技术意义大:当模型能自己闭环验收,它就不再需要用"多说话"来对冲不确定性——废话的根因被拆掉了,省 token 和提质量是同一件事的两面。
用户侧的呈现就是"许愿式编程":说清楚要什么,规划、写码、运行、自查、修复,模型自己往下推。官方演示从一句话搓出可实时浏览的 3D 故宫、能跑的网页赛车、Godot 版《传送门 2》复刻。
泼一盆冷水:许愿式编程的适用边界是"目标可验证"的任务——页面能跑、测试能过、效果能看。目标模糊、验收主观的复杂工程,人依然得在场。把它当成"验收成本低的活可以放心交给模型"的信号,比当成"程序员失业"的信号有用得多。
三、被低估的一步棋:自研 Search / Fetch API
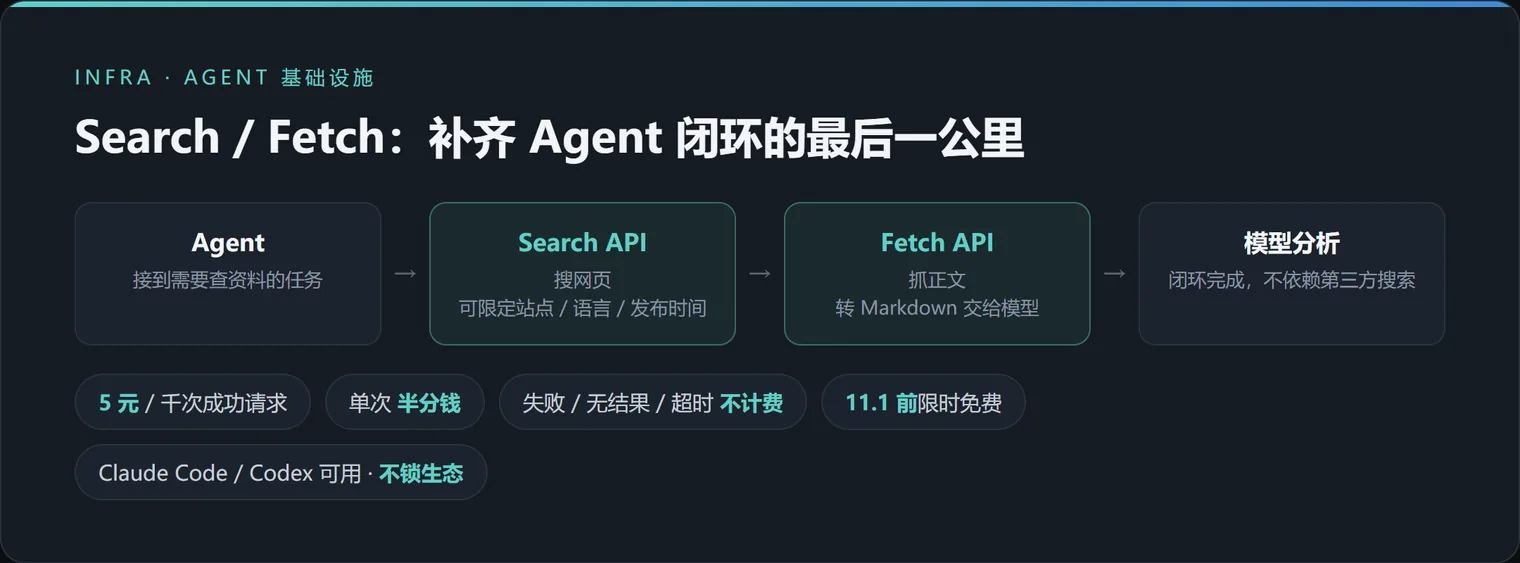
这次同步开放的还有 DeepSeek 自研搜索引擎的两个接口:Search 负责搜网页(支持限定站点、语言、发布时间),Fetch 负责抓正文转 Markdown、交给模型继续分析。
定价是基础设施打法,不是赚钱打法:
- 每千次成功请求 5 元,单次半分钱;
- 请求失败、无结果、超时,一律不计费;
- 11 月 1 日前限时免费;
- Claude Code、Codex 里调 DeepSeek 也能用,不锁生态。
为什么重要:能写码、能执行的 Agent,如果"上网查资料"要依赖第三方,能力边界就卡在别人手里。搜索是 Agent 的高频刚需,自己补齐这块拼图,闭环才算完整。
四、给开发者的三个可执行动作
- 别只看榜单,拿真实任务跑 A/B:同一任务分别跑旧模型和 1017,对比 token 账单、耗时、一次通过率——这三个数字比任何跑分都诚实。
- 检查工具链版本:要吃满专项优化,DeepSeek Harness 需升级到 0.2.1-rc.1 及以上;这次 Harness、腾讯 CodeBuddy、WorkBuddy 都做了训练期协同优化,模型层和应用层一起调,"一次许愿"的通过率才是真实的。
- 11 月 1 日前把 Search API 试起来:免费窗口期是最低成本的验证时机,重点测它在你工作流里的召回质量和延迟。
结语
性价比不是价格战,是工程能力的外显。DeepSeek 这次真正的动作,是把"更强"和"更省"从一道单选题改成了同一件事——对天天付 token 账单的人来说,这比任何跑分都实在。
基于量子位 2026-10-17 报道发散,不构成投资建议。