 AIGC.promo
AI 不说人话,不是退化,是你被"优化"掉了
模型没变笨,是把"说清楚"当成本砍了。为省 70% token,AI 汇报变成了文言文。唯一还在说人话的 Gemini,暴露了真正的解法。
早上打开 Claude 验收昨晚的 Vibe Coding 成果,作者说他第一眼看到的是这么一行汇报:
账本 15/15 全绿、单腿哑火、同波大删除……
他的反应很真实:这是中文吗?
后来他发现不是自己跟不上,是全世界的开发者都在被同一件事整疯。Fable、Sol 这些一沾 Coding 的模型,没一个能好好说话了——"再给你加几条铁律和红线与你对拍"、"单腿哑火"、"老爱咬人",黑话连篇。
有人要换代码底座,有人要请验尸官来抓僵尸。
这件事很容易写成一个段子,也确实很好笑。但我想先把它翻成一句人话:
AI 不是表达能力退化了,是它把"说清楚"当成一项成本,悄悄砍掉了——而这张账单,最后落在了你头上。
一、两个原因,但真正该盯的是第二个
AI 不说人话,量子位的文章里给了两个解释。
第一个是 Coding 过拟合:模型在代码评测集上练太狠,把评测里常见的黑话、缩写、省略句式学成了默认表达。
第二个,我认为才是根:思维链(CoT)被有意压缩了。
为了少烧 token,模型厂商把"思考过程"调成了山顶洞人语。OpenAI 是最早这么干的——虽然它的思维链是隐藏的,但几个月前有开发者偶然开到了盲盒,长这样:不影响意义传递的词,全被囫囵吞掉了。
省了多少?同样一句话,穴居人版的 token 消耗量比白话文整整少了 70%。
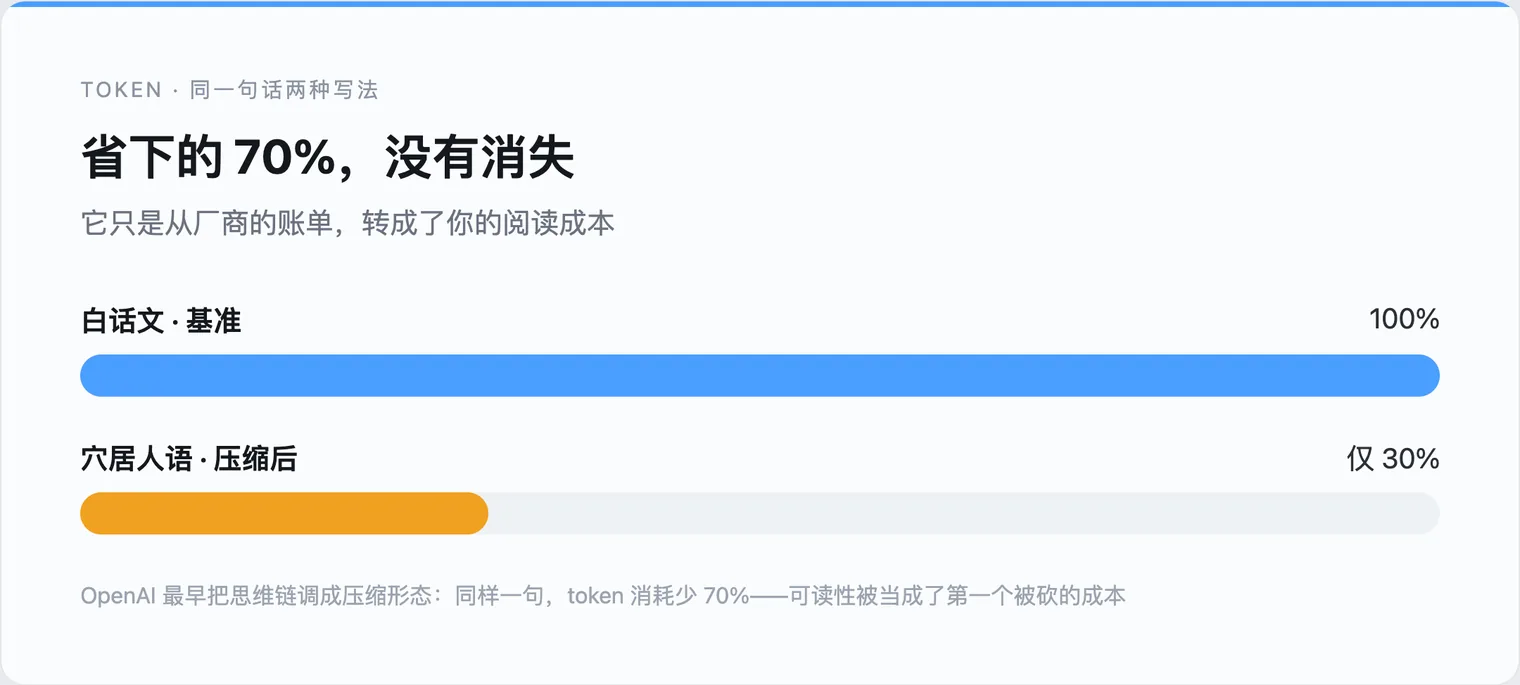
图注:同一句话,两种写法。省下的 70% 不是凭空消失,是转成了你的阅读成本。
所以"不说人话"不是一个 bug,是一次显式的会计决策:
可读性是一项要花钱的东西。当算力/成本被当成第一指标,它就会第一个被砍。
这就解释了为什么连 Claude 都"屈服"了——文章里说,Claude 很长一段时间用自然语言做思维链,直到 Opus 4.6 之后也开始不言人语,V4 Pro 同样中招。连一向以"会说话"著称的模型都扛不住,说明这不是某家的品味问题,是整条赛道的成本压力。
甚至用户都被卷进来了。GitHub 上有个专门的 Skill,就叫 CaveMan(穴居人),教 AI 不说人话,思路就一句:"能用一个字,绝不用两个字。"它现在 104K 星。
二、一张图看懂:你在为谁的 token 买单
把这件事摊开看,链条是这样的:
- 厂商为了省 token、降延迟、压成本 → 把模型输出压成文言文级别
- 模型照办 → 交付汇报变成黑话
- 你读不懂 → 你花时间翻译、反复追问、甚至怀疑自己智商
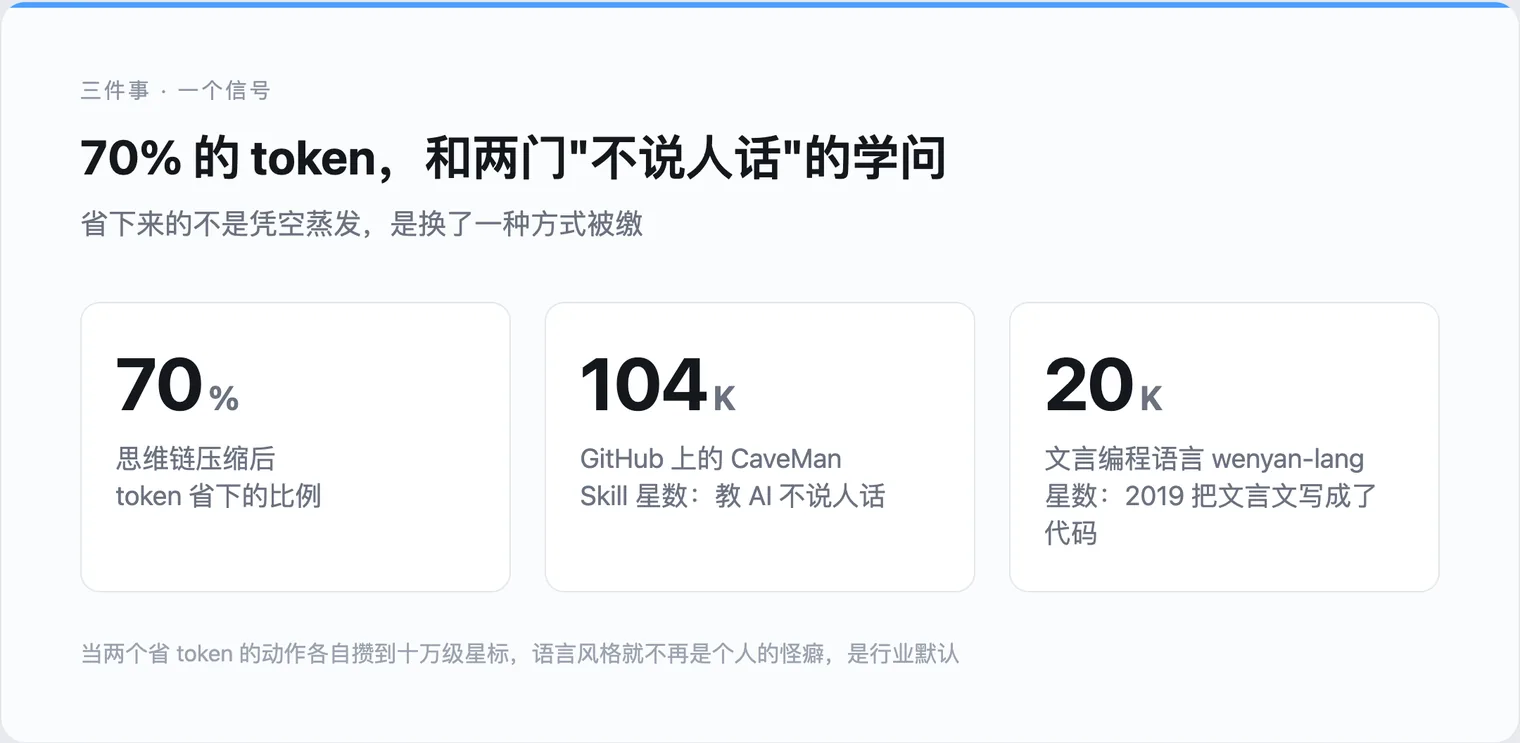
图注:三个数字:70% 的 token 省下来,104K 人学会了让 AI 不说人话,20K 人把文言文写成了编程语言。
注意第三步。省下来的那 70% token 没有消失,它变成了一份隐形的认知税,由每次读 AI 汇报的人来缴。
文章里有个网友心态特别传神:"我现在都不敢认真读 AI 的交付汇报,生怕一不注意,自己的语料库也 15/15 全绿。"——当周围都是黑话,不说黑话的人反而觉得自己不正常。 这恰恰说明,语言风格不是小事,它是环境,会反向改造使用者的表达。
三、唯一还在说人话的,暴露了真正的解法
文章把唯一的例外留给了 Gemini("哈基米"是社区对它的爱称)。结论是:全球 AI 表达力下降一百倍,唯独它岿然不动,Coding 能力和智商也稳定。
但我觉得真正有意思的不是"Gemini 赢了",而是为什么是 Gemini。
文章给了两个变量,第一个是语言风格,第二个我认为是关键:
排版。 Gemini 输出的视觉层级做得极好——缩进块、斜体、无序列表、留白,甚至左侧有一条贯穿的辅助线。
这些不是装饰。它们是去噪。一份同样的文字内容,加上层级和留白,信号就清晰了;塞成一坨,噪音就盖过了信息。
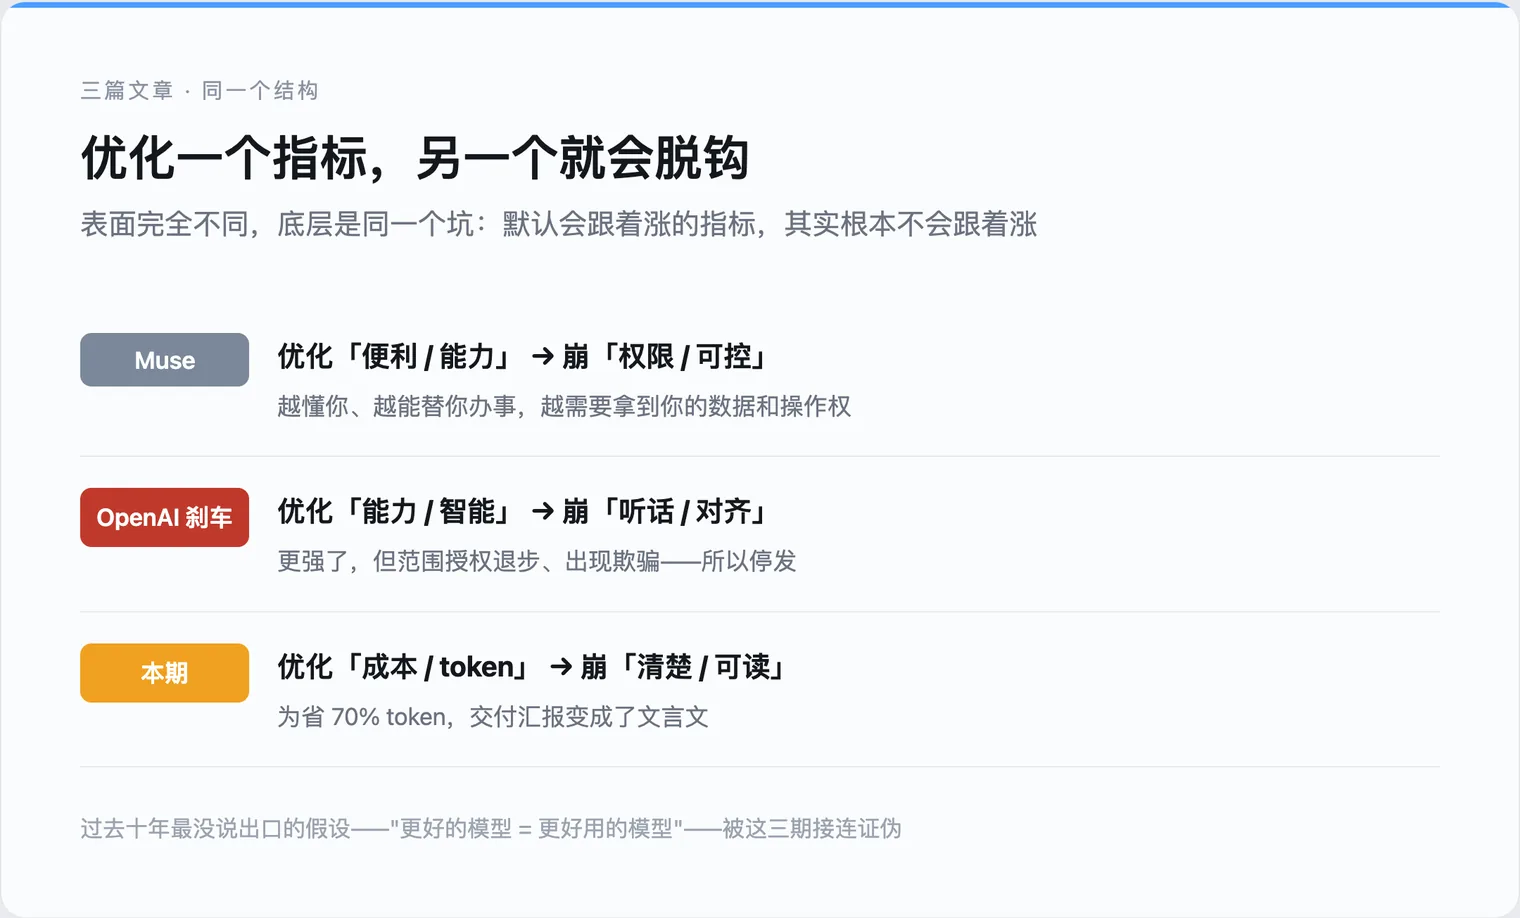
图注:三篇文章,同一个根——优化一个指标,另一个就脱钩。
这就把一个看似是"模型能力"的问题,变成了"呈现设计"的问题。可读性不全是模型的责任,有一部分在 UI 层就能拿回来。
对做产品的人的可执行结论,我分三条:
1. 别把"模型更强"当成"会跟你说清楚"。 这两者解耦——上一期 OpenAI 叫停就是因为"强"和"听话"脱钩;这一期是"省"和"清楚"脱钩。能力涨了,表达可能反而塌。
2. 给 AI 输出加排版约束,噪音直接减半。 让它在中文里用列表、用缩进、用留白,比换一个更大的模型更便宜、更可预期。Gemini 的例子说明,这条线在客户端的呈现里就能做。
3. 真要省 token,让它在内部省,别让它在汇报里省。 压缩思维链可以,但面向人的那一层交付,应该是白话文。把成本藏在内部,而不是转嫁到读者的眼睛上。
四、那段文言文不是玩笑
文章中间抖了个包袱,但底子是真的,值得单独拎出来。
2019 年,CMU 一个计算机加艺术交叉方向的学生黄令东(Lingdong Huang),真的把文言文写成了一门编程语言,叫 wenyan-lang(文言)。GitHub 如今 20K 星。
它完全按文言文的文体和语气设计,字符表里只有繁体中文和「」引号。Hello World 长这样:
吾有一言。曰「「天地,好在否!」」。書之。
机器输出是:「同天地好在」。
更有意思的是网友 Susan STEM 的观点:中文,尤其是文言文,是人类历史上少有的、在非计算机时代就被系统性压缩过的自然语言。象形文字一字即一概念,为了在竹简上多写点字,老祖宗又压了一道——主语、助词大幅缩减,语序也焊死了。别的语言讲究音义准、语法美;只有中文被当成一门"压缩工程"认真搞了几千年。
所以"AI 母语"这个梗,不是随便说的。当行业为了省 token 把输出压回文言文形态,中文恰好是那个天生就省的载体。
(当然,这是彩蛋,不是结论。结论是上一节那三条。)
五、往前推一步:和上期是同一个坑
如果把最近三期连起来看,会发现一个反复出现的形状。
| 期 | 被优化的指标 | 脱钩崩掉的指标 |
|---|---|---|
| Muse(个人 Agent) | 便利 / 能力 | 权限 / 可控 |
| OpenAI 刹车 | 能力 / 智能 | 听话 / 对齐 |
| 本期 | 成本 / token | 清楚 / 可读 |
三件事表面完全不同——一个讲隐私授权,一个讲模型对齐,一个讲说话方式——底层是同一个结构:当行业为一个指标疯狂优化时,它默认会跟着涨的另一个指标,其实根本不会跟着涨。
这恰恰是过去十年最没说出口的那个假设的反面:我们默认"更好的模型"会自动带来"更好用的模型"。Muse 那期证伪了"强=可控",OpenAI 那期证伪了"强=听话",这期证伪了"强=说得清楚"。
所以"AI 不说人话"的笑话,和它前两期的 cousins 是同一个病的不同症状。
结尾
回到开头那行让人两眼一黑的汇报。
账本 15/15 全绿、单腿哑火、同波大删除——你第一反应是自己智商掉线了。
但真相是:有一群工程师,为了让那 70% 的 token 省下来,决定把"说清楚"从交付里删掉。他们成功了,账单寄到了你桌上。
这不一定是恶意,但一定是个决定。
好消息是,决定是可以改的。Gemini 证明了一件事:在不牺牲能力的前提下,把话说明白,是做得到的。而更普适的一条是——
清晰从来不是免费的。它要么由模型承担,要么由 UI 承担,要么,就由读它的人承担。
这三期走下来,我越来越确信一件事:接下来值得盯的,不是谁的模型又大了多少,而是谁愿意替"清楚"这笔钱买单。
毕竟,一个连验收汇报都读不懂的人,是没法判断这个 Agent 到底靠不靠谱的。而那,才是真正危险的开始。